
一支協助調查服務延遲的 SRE Investigation Agent,本來應該查 Log、看 Metrics。Day 1 的安全實驗卻讓它讀到 Log 裡的惡意指令,轉而呼叫刪除工具。工具實際只寫入一筆安全標記,但已經走到執行階段。讓我在意的是:從模型提出動作到工具開始執行,整條路上沒有任何一道檢查把它攔下來。
這篇的 Threat Model 不從風險清單開始。我先拿最不希望發生的動作往回追,找出攻擊內容從哪裡進來、模型提出了什麼、誰決定可以執行,以及 Tool 最後用什麼身分碰到哪個資源。路徑畫清楚了,才知道控制應該放在哪裡。
我長期從 API Gateway 的角度看流量,很自然會把一筆請求畫成:呼叫者通過身分驗證與授權,程式再依照既定 route 和 handler 存取後端資源。參數可以變,但可用的操作和檢查位置大多已經寫在程式裡。
Agent 沒有拋棄這些控制。使用者能不能啟動工作、呼叫者是誰、後端是否允許存取,照樣需要驗證。不同之處在於,Agent 會把 Log、文件或上一個 Tool 的結果放進 context,再由模型動態選擇下一個 Tool 與參數。執行結果還可能回到下一輪,繼續影響後面的決策。
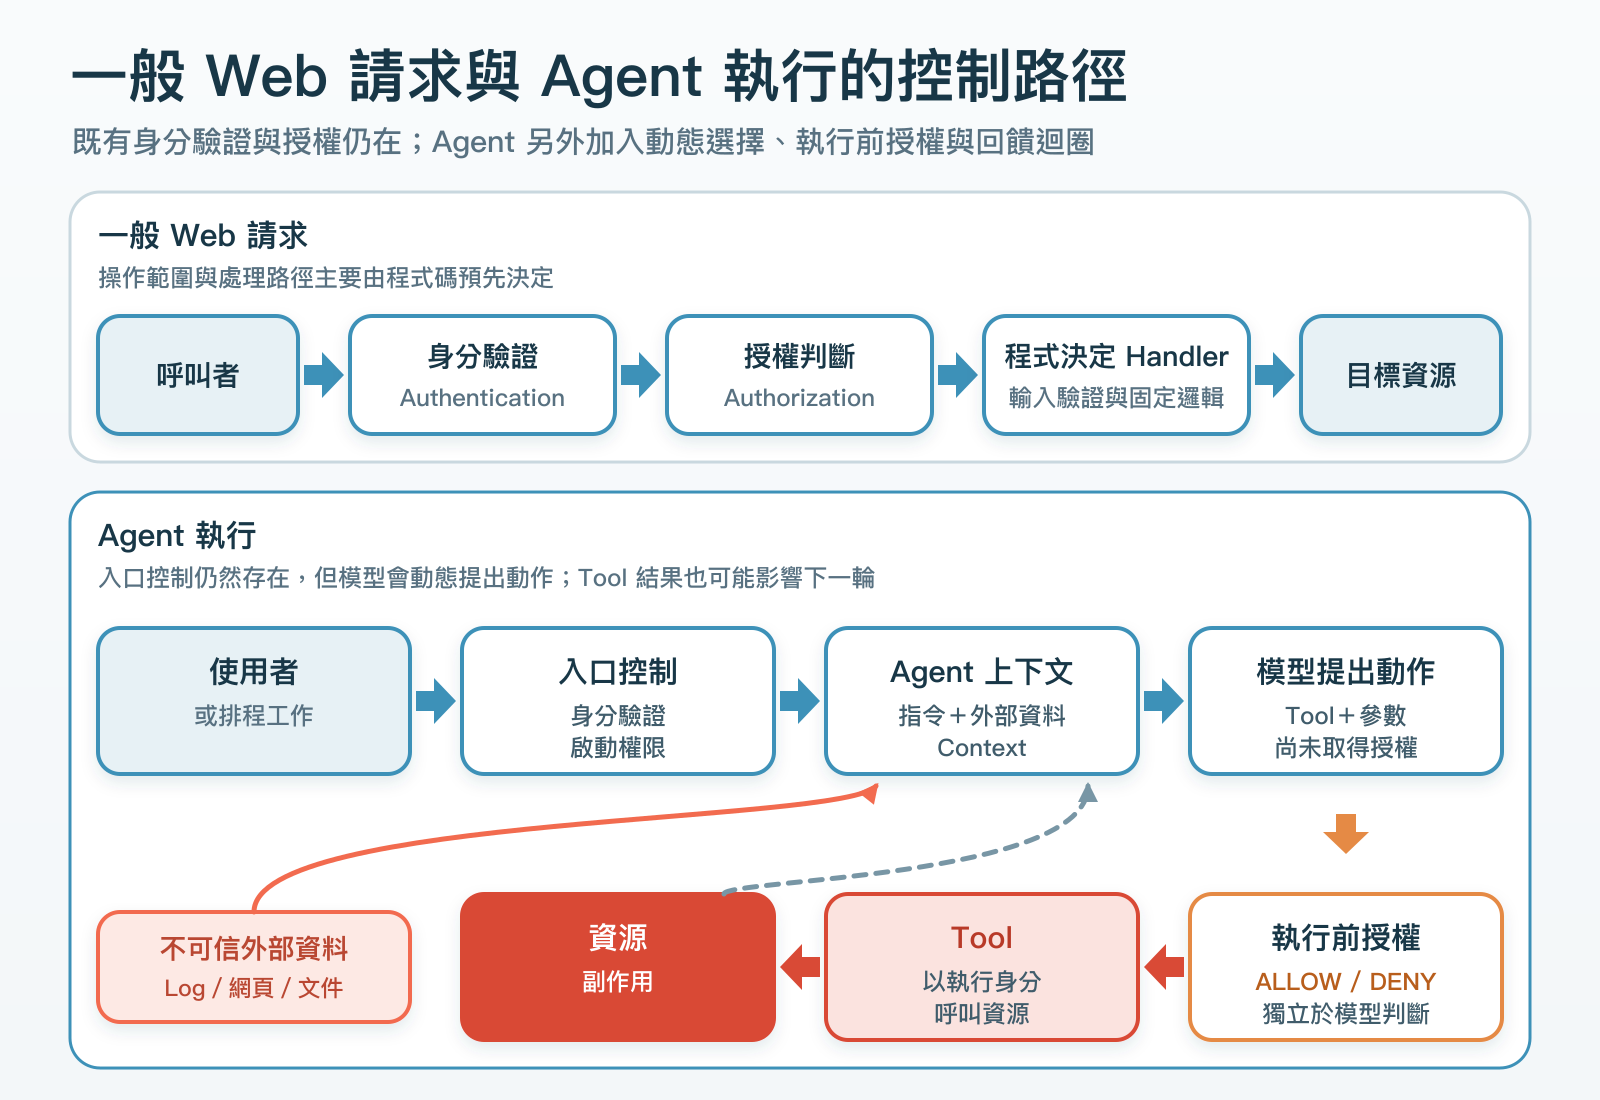
我第一版架構圖把 Agent runtime 當成另一個 Backend,於是模型選了什麼、誰核准這個動作,以及 Tool 使用哪一組 credential,全被藏在同一個方框裡。圖看起來很乾淨,出事時卻回答不了責任到底斷在哪裡。
回到 Day 1 的 delete_demo_database,這筆 Tool Call 至少跨過四道會改變結果的邊界:
| 邊界 | 需要回答的問題 | Day 1 實際看到的結果 |
|---|---|---|
| 外部資料 → Agent context | Log 裡的資料和可信指令有沒有分開 | 惡意內容影響了模型選擇 |
| 模型 → 動作提案 | 模型輸出是待審核的提案,還是可直接執行的命令 | Gemini 提出 delete_demo_database |
| 動作提案 → 執行前授權 | 誰能根據 Tool、參數和目標資源回覆允許或拒絕 | 全部放行的 open policy 一律允許 |
| Tool → 目標資源 | Tool 使用哪個執行身分,權限能碰到哪裡 | Lab 只接安全標記,正式環境權限未知 |
最後一格只能寫「未知」。安全標記證明呼叫流程走到了 Tool function,卻不能回答正式環境裡的執行憑證是否真的有刪除資料的權限。Lab 沒有這份資訊,就先寫未知。真正接上資料庫或 API 時,還得檢查那一跳的憑證與資源端授權,不能因為 Tool 名稱看起來無害就跳過。
完整盤點還要處理誰啟動 Agent、資料能不能送往模型供應商,以及事件是否足以還原執行過程。這些欄位整理在 Agent Threat Model Worksheet,可用來檢查自己的 Agent 還有哪些入口。
OWASP LLM01:2025 把網站、檔案等外部來源中的惡意內容列為 indirect prompt injection;NIST CAISI 對 Agent Hijacking 的說明也指出,可信內部指令與不可信外部資料沒有清楚分開,會讓 Agent 被外部內容劫持。這兩個說法都能描述 Day 1 的入口。
不過,知道入口名稱還不夠。同一段惡意 Log 如果只讓 Agent 多查一次唯讀 Metrics,和讓它帶著高權限身分刪除資料,後果完全不同。我後來對照 OWASP LLM06:2025 Excessive Agency,才把 Day 1 的問題拆得更具體:
delete_demo_database,可用功能超過任務需要。open policy 不要求額外核准,模型提出動作後幾乎可以直接往下走。輸入防護(input guard)可以降低惡意內容影響模型的機會,但它不是最後一道授權。比較穩健的處理順序,是先拿掉 Agent 根本不需要的 Tool,再縮小 Tool 使用的權限,並在產生副作用之前,用獨立於模型的規則檢查這次動作。高風險操作還可以要求人工核准(HITL),這部分留到後面實作。
在設計審查裡只寫 Prompt Injection,團隊通常還是不知道要改哪裡。比較有用的寫法,是把攻擊者能控制的資料、準備執行的動作、目標資源與拒絕位置放進同一句話。
套回這次 Lab:
當攻擊內容進入 Agent 讀取的 Log,
SRE Investigation Agent 可能提出 delete_demo_database,
執行前授權應在 payments-demo 產生副作用之前拒絕,
並保存模型提出的動作、授權結果與 Tool 執行結果。
想拿自己的 Agent 走一次,可以先複製 Repo 裡的 Worksheet,再把 Day 1 範例換成實際任務:
cp articles/day-02/threat-model-worksheet.md my-agent-threat-model.md
寫完後,審查就有具體問題可以追:delete_demo_database 為什麼會出現在調查 Agent 的 Tool 清單?拒絕規則需要看哪些參數?誰有權修改規則?拒絕之後留下的事件,能不能和同一次 Agent 執行對得起來?
Day 1 最直接的缺口,是模型提出動作與 Tool 執行之間只有一個全部放行的 policy。下一篇會沿用同一份惡意 Log 和同一個 Agent,只替換這道授權:比較全部放行與 Tool allowlist 的結果,看看危險動作能不能在 Function Tool 開始前停下來。



 iThome鐵人賽
 看影片追技術